
Labeltune
Piattaforma di annotazione dati con task builder, trascrizione audio e analytics di accordo tra annotatori.
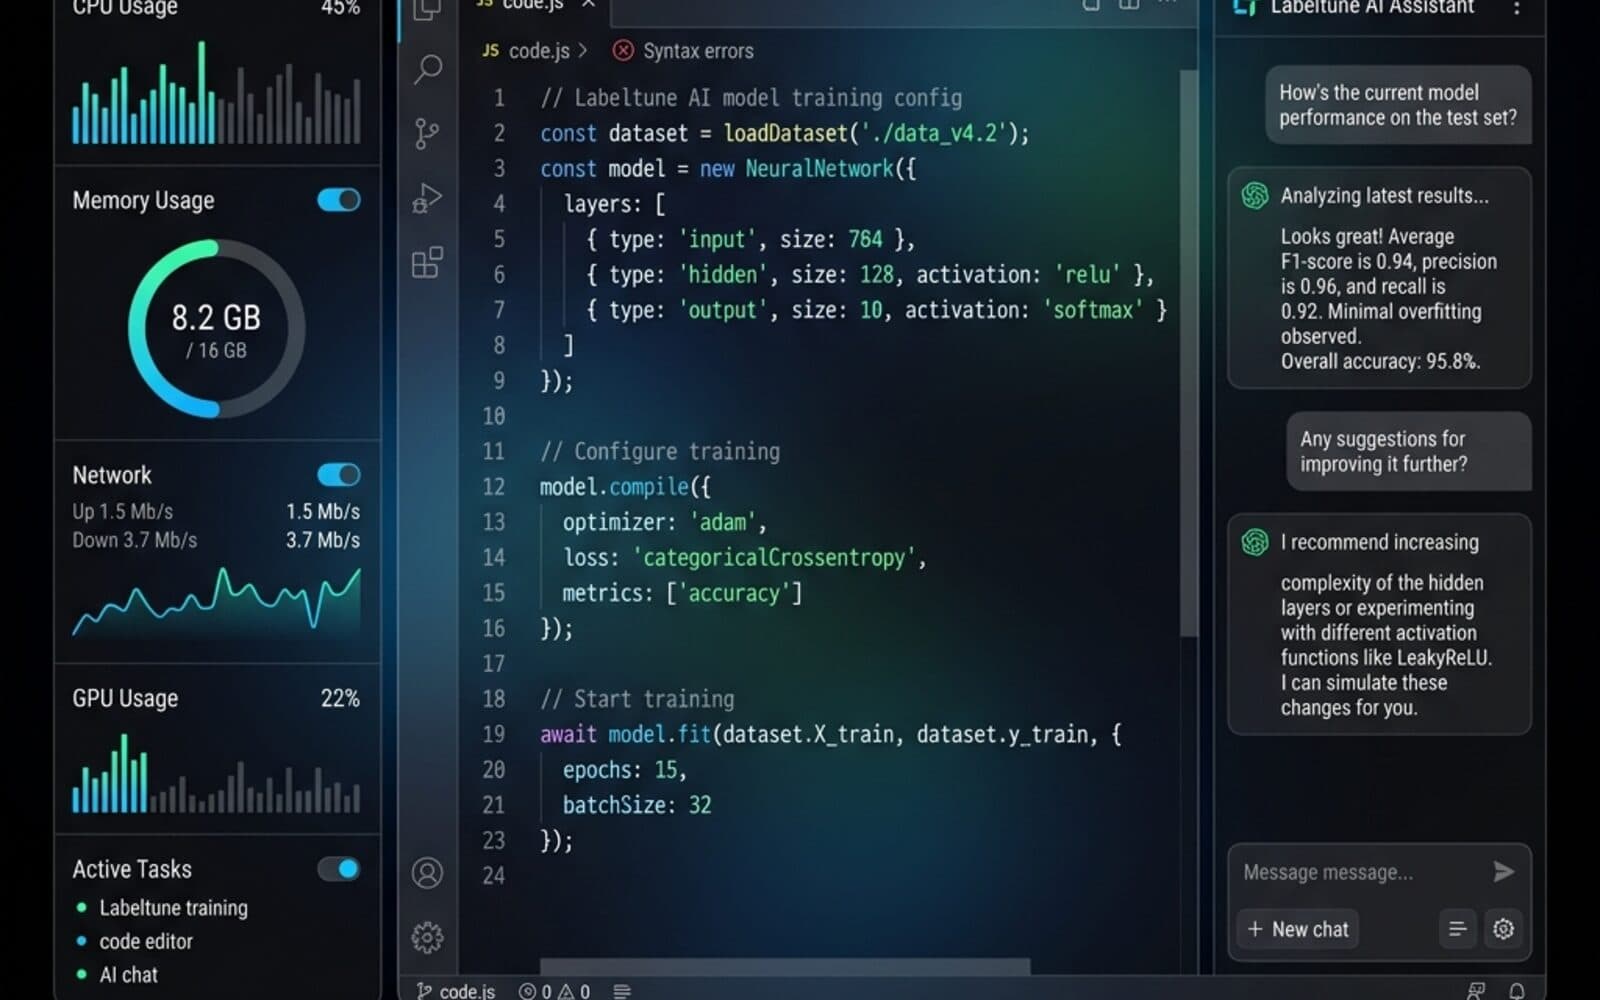
Panoramica
Labeltune nasce da una convinzione precisa: per addestrare modelli che capiscano davvero l'italiano servono dati italiani, prodotti da persone italiane. Le piattaforme di data labeling esistenti sono pensate per il mercato globale e trattano la lingua e la cultura locali come un dettaglio.
Il cuore del prodotto è una community di annotatori con un percorso di onboarding obbligatorio fatto di corsi e quiz: nessuno tocca un dataset prima di aver dimostrato di aver capito le linee guida. Sopra c'è un task builder visuale drag-and-drop, con istruzioni che l'AI contribuisce ad arricchire.
Per i task audio c'è un editor di waveform con trascrizione Whisper integrata, così chi annota ascolta, corregge e segmenta nello stesso posto. Per i committenti c'è un pannello enterprise con dataset explorer, analytics di qualità e controlli misurabili come l'accordo tra annotatori (Cohen's Kappa).
Ho progettato il prodotto attorno al concetto di dataset tracciabile e riproducibile: ogni esempio conserva chi l'ha annotato, con quali istruzioni e in che versione. È la differenza tra un mucchio di etichette e un asset di training di cui ci si può fidare.
Lo stack è interamente moderno — Next.js 16, React 19, TypeScript, Tailwind CSS 4, Framer Motion e Supabase — e la community conta oltre 4.500 talenti. Labeltune è il tentativo di costruire l'infrastruttura dati che manca all'ecosistema AI italiano.
Risultati
La piattaforma abilita la produzione di dataset di training e fine-tuning in modo strutturato, con controlli di qualità misurabili come l'accordo tra annotatori (Cohen's Kappa).
Cosa contiene
- Task builder drag-and-drop con istruzioni arricchite dall'AI
- Editor di waveform con trascrizione Whisper
- Corsi e quiz di onboarding obbligatori
- Analytics enterprise e dataset explorer